7. 応用への道(20分)#
この章ではデータ分析の応用分野を紹介します。また、応用の実践例としてWebページからスクレイピングによって情報を取り出し、DataFrameにまとめる流れを講師が実演します。
注釈
入力が遅れた場合などに、この章のNotebookをダウンロードできます。ダウンロードしたファイルを作業フォルダに置き、JupyterLabのファイルブラウザでダブルクリックして開いてください。
講義中は講師の実演を見るだけにし、自分で試すのは講義の後にしてください。対象サイトへのアクセスが一度に集中することを避けるためです。
7.1. データ分析の応用分野#
講座ではデータの入力、加工、可視化を学びました。この先には、データを使って予測したり、さまざまな形式の情報を扱ったりする応用があります。ここでは4つの分野を紹介します。
機械学習#
機械学習は、データから規則性を学び、予測や分類を行う分野です。売上や需要の予測、問い合わせ内容の分類などに使われます。代表的なライブラリにscikit-learnがあります。
スクレイピング#
Webページから必要な情報をプログラムで取り出すことをスクレイピングといいます。用途としては、商品の価格調査や公開情報の定期的な収集などが考えられます。RequestsでWebページをダウンロードし、Beautiful Soup 4で必要な要素を抜き出せます。詳しくは次節以降で解説します。
画像処理#
画像処理は、画像を加工したり、画像から特徴を取り出したりする分野です。製品の外観検査や書類画像の整理などに使われます。代表的なライブラリにPillowやOpenCVがあります。また、画像に写っている人や物を検出するUltralytics YOLOも広く使われています。
自然言語処理#
自然言語処理は、人が使う言葉をコンピューターで扱い、文章を単語に分けたり意味や傾向を調べたりする分野です。アンケートの自由記述の分析や問い合わせの自動振り分けなどに使われます。代表的なライブラリにspaCyやGiNZAがあります。
ここで紹介したライブラリのうち、講座の環境に入っているのはRequestsとBeautiful Soup 4だけです。ほかのライブラリを試すときは、別途インストールが必要です。
ここからはスクレイピングの概要と、スクレイピングを行う際の注意点を説明します。その後、python.orgのWebページをダウンロードし、Pythonのリリース情報を抜き出してDataFrameにまとめる流れを解説します。
7.2. スクレイピングとは#
スクレイピングは、Webページから必要な情報をプログラムで取り出すことです。Webブラウザに表示されるページの内容は、HTMLという形式のテキストで書かれています。スクレイピングでは、プログラムでHTMLテキストをダウンロードし、必要な部分を抜き出して、プログラムが扱いやすい形にまとめます。
画面を見ながら手作業でコピー&ペーストする場合と比べて、多くのページから情報を集めたり、同じ作業を定期的に繰り返したりする作業を自動化できます。
7.3. スクレイピングを行う際の注意点#
スクレイピングでは、相手のサイトにプログラムでアクセスするため、サイトに負担をかけたり、サイトのルールに反したりしないよう注意する必要があります。スクレイピングを行う際は、次の点に注意してください。
対象サイトの利用規約とrobots.txtに従う
robots.txtはサイトの直下に置かれ、プログラムによる取得を許可・禁止するページを示すファイル
アクセスの頻度を抑え、同じページに繰り返しアクセスしない
取得したデータはファイルに保存して使い回す
CSVのダウンロードやAPIなどデータの提供があれば、そちらを優先する
ボット対策(CAPTCHAなど)でプログラムからのアクセスを拒否しているサイトは対象にしない
7.4. Webページをダウンロードする#
ここでは、python.orgのダウンロードページをスクレイピングの対象にします。このページの「Looking for a specific release?」には、Pythonの過去のリリースが新しい順に並んでいます。各行には、バージョン、リリース日、ダウンロードのリンク、リリースノートのリンクがあります。
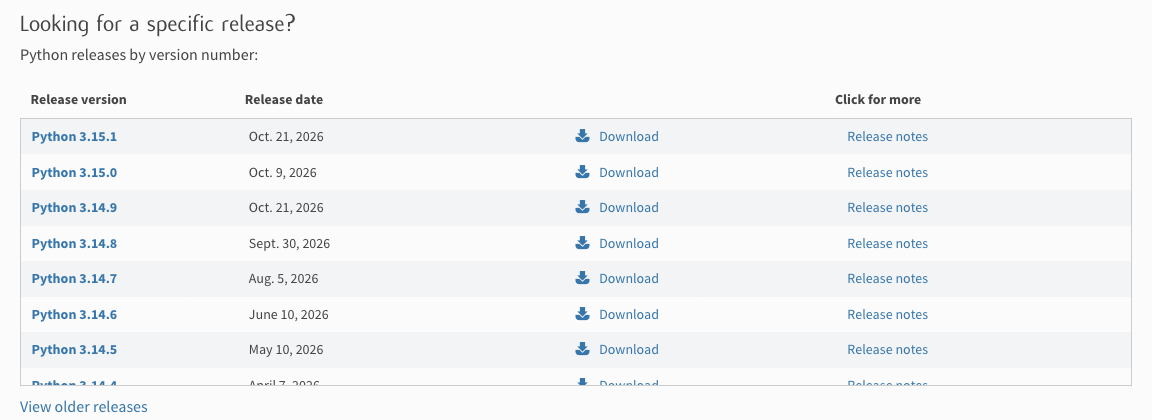
python.orgのリリース一覧(出典: Python Software Foundation、python.org)#
python.orgのrobots.txtを確認すると、次のように書かれています(抜粋)。取得が禁止(Disallow)されているのは/~guido/orlijn/と/webstats/だけで、/downloads/の取得は許可されています。
# Hide old versions of the documentation and various large sets of files.
User-agent: *
Disallow: /~guido/orlijn/
Disallow: /webstats/
Webページのダウンロードには、Requestsを使います。requestsをインポートし、get()関数でページをダウンロードします。戻り値(r)のstatus_codeが200なら、ダウンロードに成功しています。
import requests

url = "https://www.python.org/downloads/"
r = requests.get(url)  # Webページをダウンロード
r.status_code  # 200なら成功
200
ダウンロードしたHTMLは、r.textに文字列として入っています。中身が正しいかを確認するため、HTMLを1行ずつ調べて、<title>という文字列を含む行を表示します。splitlines()メソッドは、文字列を行ごとに分けたリストを返します。
# HTMLを1行ずつ調べ、<title>を含む行を前後の空白を除いて表示
for line in r.text.splitlines():
    if "<title>" in line:
        print(line.strip())
<title>Download Python | Python.org</title>
ページのタイトルが表示され、目的のページをダウンロードできたことが分かります。
7.5. Webページから要素を抜き出す#
さきほどは文字列の処理で<title>を含む行を抜き出しました。しかし、HTMLから複雑な要素を文字列の処理で抜き出すのは大変です。そこで、HTMLを構文解析して、要素を探しやすい形にします。HTMLの文字列を読み取り、タグの構造をたどれる形にすることをパース(構文解析)といいます。
HTMLはWebページの内容と構造をタグで囲んで表す書き方です。たとえば、<title>と</title>で囲んだ部分はページのタイトル、<a>と</a>で囲んだ部分はリンクを表します。タグにはclassやhrefなどの属性を付けられます。
Beautiful Soup 4を使うと、HTMLをパースして、タグを指定して要素を取り出せます。BeautifulSoup()にHTMLの文字列とパーサー("html.parser"はPythonの標準ライブラリのパーサー)を渡すと、パースした結果が返ります。まずは<title>タグを抜き出します。
from bs4 import BeautifulSoup

soup = BeautifulSoup(r.text, "html.parser")  # HTMLをパース
soup.title  # <title>タグを取り出す
<title>Download Python | Python.org</title>
さきほど文字列の処理で抜き出したのと同じ<title>タグを取り出せたことが確認できます。
find_all()メソッドは、条件に合うすべての要素をリストで返します。ページ内のすべての<a>タグ(リンク)を探し、全件数と、先頭5件のリンク文字列とhref属性の中身(リンク先)を出力します。.textで要素の中の文字列を、["href"]で属性の値を取り出せます。
links = soup.find_all("a")  # すべての<a>タグを取得
print(f"aタグの数: {len(links)}")
for link in links[:5]:
    print(f"タイトル: {link.text.strip()}")  # <a>タグの文字列を取得
    print(f"リンク: {link["href"]}")  # <a>タグのリンク先を取得
aタグの数: 1032
タイトル: Skip to content
リンク: #content
タイトル: ▼ Close
リンク: #python-network
タイトル: Python
リンク: /
タイトル: PSF
リンク: https://www.python.org/psf/
タイトル: Docs
リンク: https://docs.python.org
7.6. Pythonのリリース情報を抜き出す#
それでは、このページからリリース情報を抜き出します。各リリース情報から、バージョン、リリース日、ダウンロードのURL、リリースノートのURLを取得します。
python.orgのリリース一覧(出典: Python Software Foundation、python.org)#
プログラムを作成する前に、HTMLの構成を確認します。リリース一覧のHTMLは次の内容です(この資料を作成したときの先頭2件分。見やすいようにインデントを整えています)。
<div class="row download-list-widget">
<h2 class="widget-title">Looking for a specific release?</h2>
<p class="success-quote">Python releases by version number:</p>
<div class="list-row-headings">
<span class="release-number">Release version</span>
<span class="release-date">Release date</span>
<span class="release-download"> </span>
<span class="release-enhancements">Click for more</span>
</div>
<ol class="list-row-container menu">
<li>
<span class="release-number"><a href="/downloads/release/python-3151/">Python 3.15.1</a></span>
<span class="release-date">Oct. 21, 2026</span>
<span class="release-download"><a href="/downloads/release/python-3151/"><span aria-hidden="true" class="icon-download"></span> Download</a></span>
<span class="release-enhancements"><a href="https://docs.python.org/release/3.15.1/whatsnew/changelog.html">Release notes</a></span>
</li>
<li>
<span class="release-number"><a href="/downloads/release/python-3150/">Python 3.15.0</a></span>
<span class="release-date">Oct. 9, 2026</span>
<span class="release-download"><a href="/downloads/release/python-3150/"><span aria-hidden="true" class="icon-download"></span> Download</a></span>
<span class="release-enhancements"><a href="https://docs.python.org/release/3.15.0/whatsnew/changelog.html">Release notes</a></span>
</li>
...
</ol>
</div>
このHTMLは次のような構成になっています。
クラス名が
download-list-widgetの<div>タグが、リリース一覧の部分全体を囲んでいる中には、見出し(
<h2>)、説明文(<p>)、列の見出し行(list-row-headingsの<div>)、リリース一覧(<ol>)がある
<ol>タグがリリース一覧、その中の<li>タグ1つがリリース1件を表す<li>の中に4つの<span>タグがあり、class属性の値(クラス名)で項目の種類を区別しているrelease-number: バージョンrelease-date: リリース日release-download: ダウンロードのリンクrelease-enhancements: リリースノートのリンク
リンクは
<a>タグで、href属性の値がリンク先のURLを表す。ダウンロードのリンクは、サイト内のパス(/downloads/release/...)で書かれている
列の見出し行にもrelease-numberなどのクラス名があり、ページには同じクラス名の<ol>がもう1つあります。そのため、download-list-widgetの<div>を探し、その中の<li>をすべて取り出します。find()メソッドは、条件に合う最初の要素を返します。
# リリース一覧を囲む<div>を探し、その中の<li>をすべて取得
release_list = soup.find("div", class_="download-list-widget")
items = release_list.find_all("li")
len(items)  # リリースの件数
269
引数のclass_に_が付くのは、classがPythonの予約語だからです。件数は取得した日によって変わります。
リリースごとに、バージョン、リリース日、ダウンロードのURL、リリースノートのURLを取り出します。ダウンロードのリンクはサイト内のパスなので、先頭に"https://www.python.org"を付けてURLにします。
versions = []
dates = []
downloads = []
notes = []

for item in items:
    # クラス名で<span>を探し、文字列は.text、リンク先は<a>タグのhref属性で取り出す
    versions.append(item.find("span", class_="release-number").text)
    dates.append(item.find("span", class_="release-date").text)
    path = item.find("span", class_="release-download").find("a")["href"]
    downloads.append("https://www.python.org" + path)
    notes.append(item.find("span", class_="release-enhancements").find("a")["href"])
7.7. DataFrameにする#
pandasをインポートし、第5章と同じく、列名と値のリストを辞書で渡してDataFrameを作ります。
リリース日は「Oct. 21, 2026」のような英語の文字列で、月には「Oct.」「Sept.」のような省略形と「June」のような省略しない形が混在しています。pd.to_datetime()関数で、文字列を日付の型(datetime)に変換します。format="mixed"を指定すると、書き方がそろっていない日付もそれぞれ読み取って変換します。
import pandas as pd

# 列名と値のリストの辞書からDataFrameを作成
df = pd.DataFrame({
    "version": versions,
    "release_date": pd.to_datetime(dates, format="mixed"),  # 日付の型に変換
    "download_url": downloads,
    "release_notes": notes,
})
df.head()  # 先頭の5行を表示
| version | release_date | download_url | release_notes | |
|---|---|---|---|---|
| 0 | Python 3.15.1 | 2026-10-21 | https://www.python.org/downloads/release/pytho... | https://docs.python.org/release/3.15.1/whatsne... |
| 1 | Python 3.15.0 | 2026-10-09 | https://www.python.org/downloads/release/pytho... | https://docs.python.org/release/3.15.0/whatsne... |
| 2 | Python 3.14.9 | 2026-10-21 | https://www.python.org/downloads/release/pytho... | https://docs.python.org/release/3.14.9/whatsne... |
| 3 | Python 3.14.8 | 2026-09-30 | https://www.python.org/downloads/release/pytho... | https://docs.python.org/release/3.14.8/whatsne... |
| 4 | Python 3.14.7 | 2026-08-05 | https://www.python.org/downloads/release/pytho... | https://docs.python.org/release/3.14.7/whatsne... |
表の形ではないWebページの情報を、第5章で学んだDataFrameにまとめられました。列はversion、release_date、download_url、release_notesの4つで、release_dateは日付の型、ほかは文字列です。
この後は、第5章で学んだ方法で抽出や集計をしたり、第6章で学んだグラフで可視化したりできます。
7.8. この章のまとめ#
節 |
行ったこと |
使ったライブラリ・関数・メソッドなど |
|---|---|---|
データ分析の応用分野 |
機械学習、スクレイピング、画像処理、自然言語処理の紹介 |
scikit-learn、Requests、Beautiful Soup 4、Pillow、OpenCV、Ultralytics YOLO、spaCy、GiNZA |
スクレイピング |
Webページのダウンロード、要素の抜き出し、DataFrameの作成 |
|
実演ではWebページの情報をDataFrameにし、講座で学んだ入力 ➔ 加工 ➔ 可視化の「入力」につなげました。次の第8章では、講座全体を振り返ります。